

Forschung | KI scheitert an Overcooked: Selbst das beste Modell schafft nur 26 Prozent
Forschende haben aus dem spaßigen Couch-Multiplayer-Game Overcooked eine KI-Testumgebung namens DuoCook erschaffen, in der KI-Modelle beweisen sollen, dass sie visuelle Informationen verstehen, Aufgaben planen und mehrere Arbeitsschritte koordinieren können.
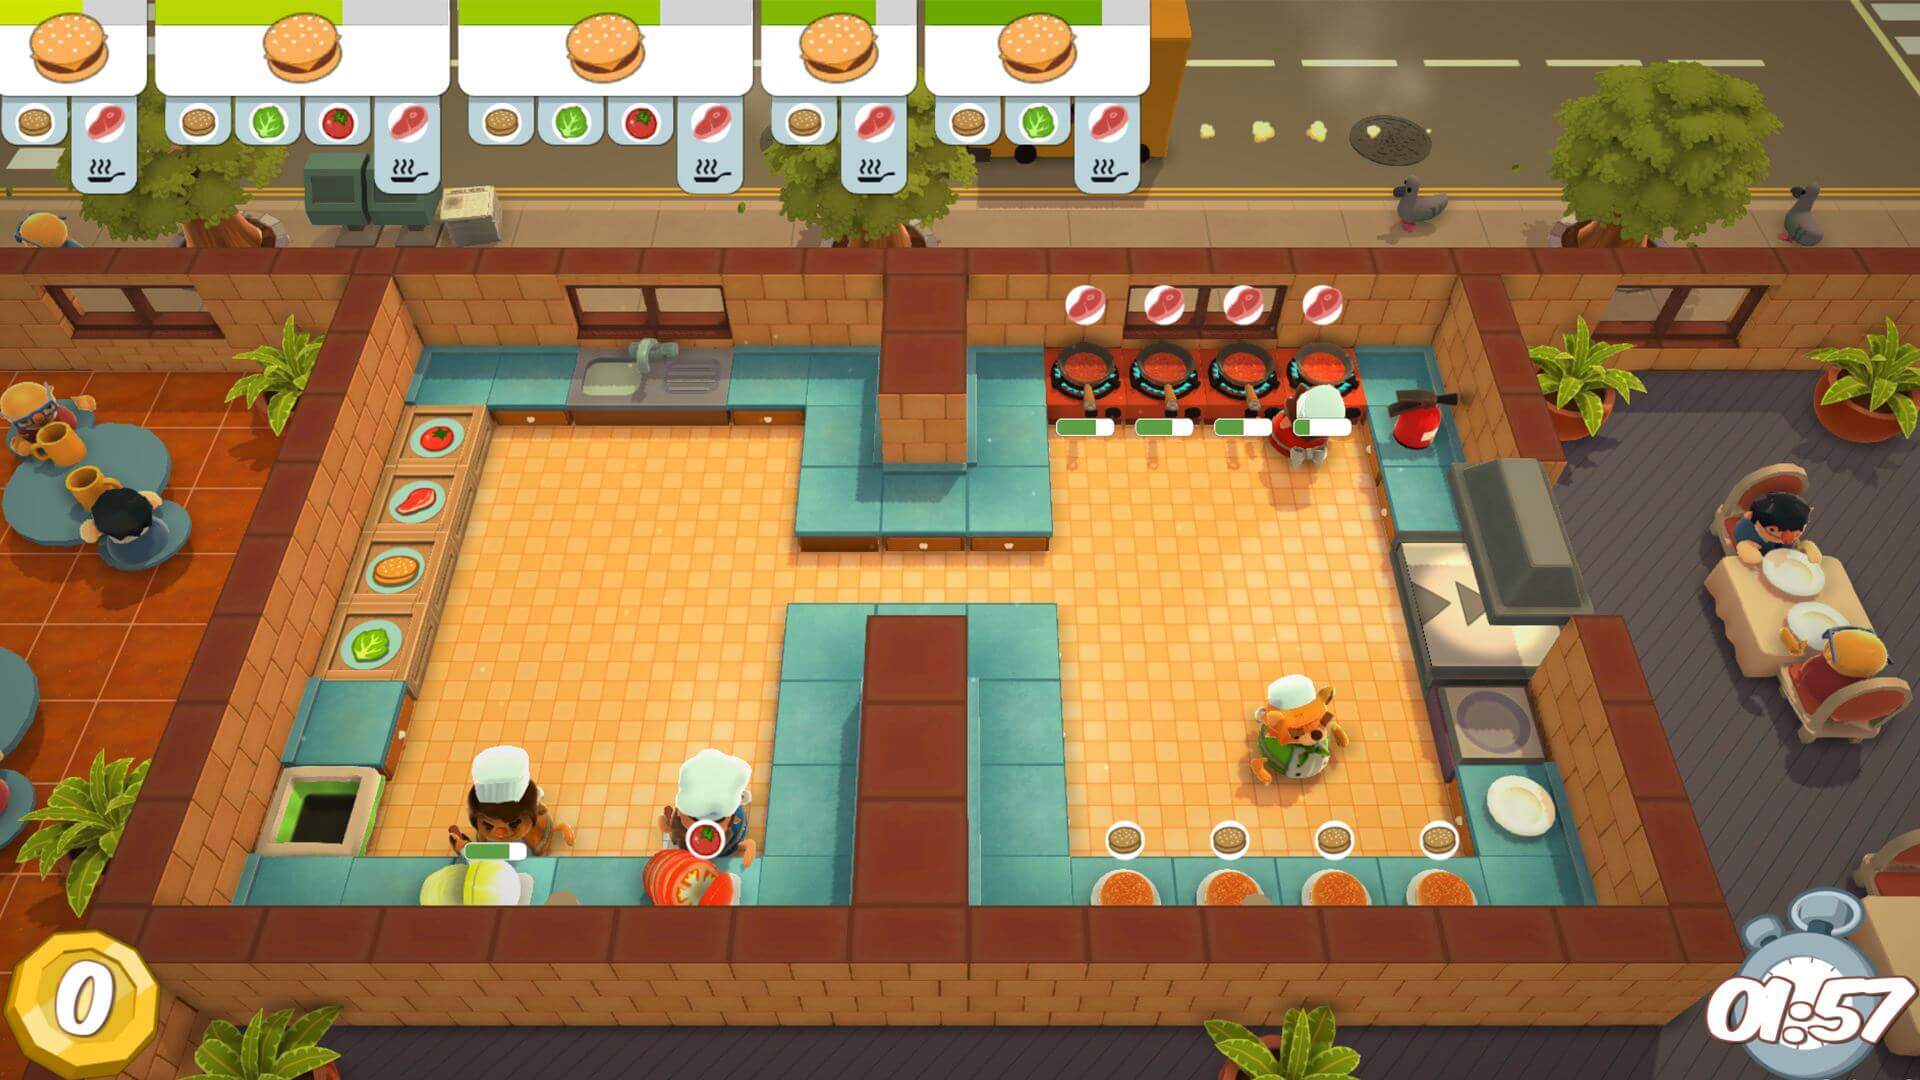
Im chaotischen Koop-Spiel Overcooked arbeiten normalerweise 2 bis 4 Personen in einem virtuellen Restaurant zusammen, um Zutaten zu schneiden, zu kochen, abzuwaschen und die fertigen Mahlzeiten rechtzeitig auszuliefern bevor die Gäste ungeduldig werden und stornieren. Dabei kommt es auf eine gute Zusammenarbeit an, die verschiedenen Arbeitsschritte müssen gut auf die Personen aufgeteilt werden um effizient und so schnell wie möglich zu sein – ein herrliches Durcheinander und ein toller Koop-Spaß.
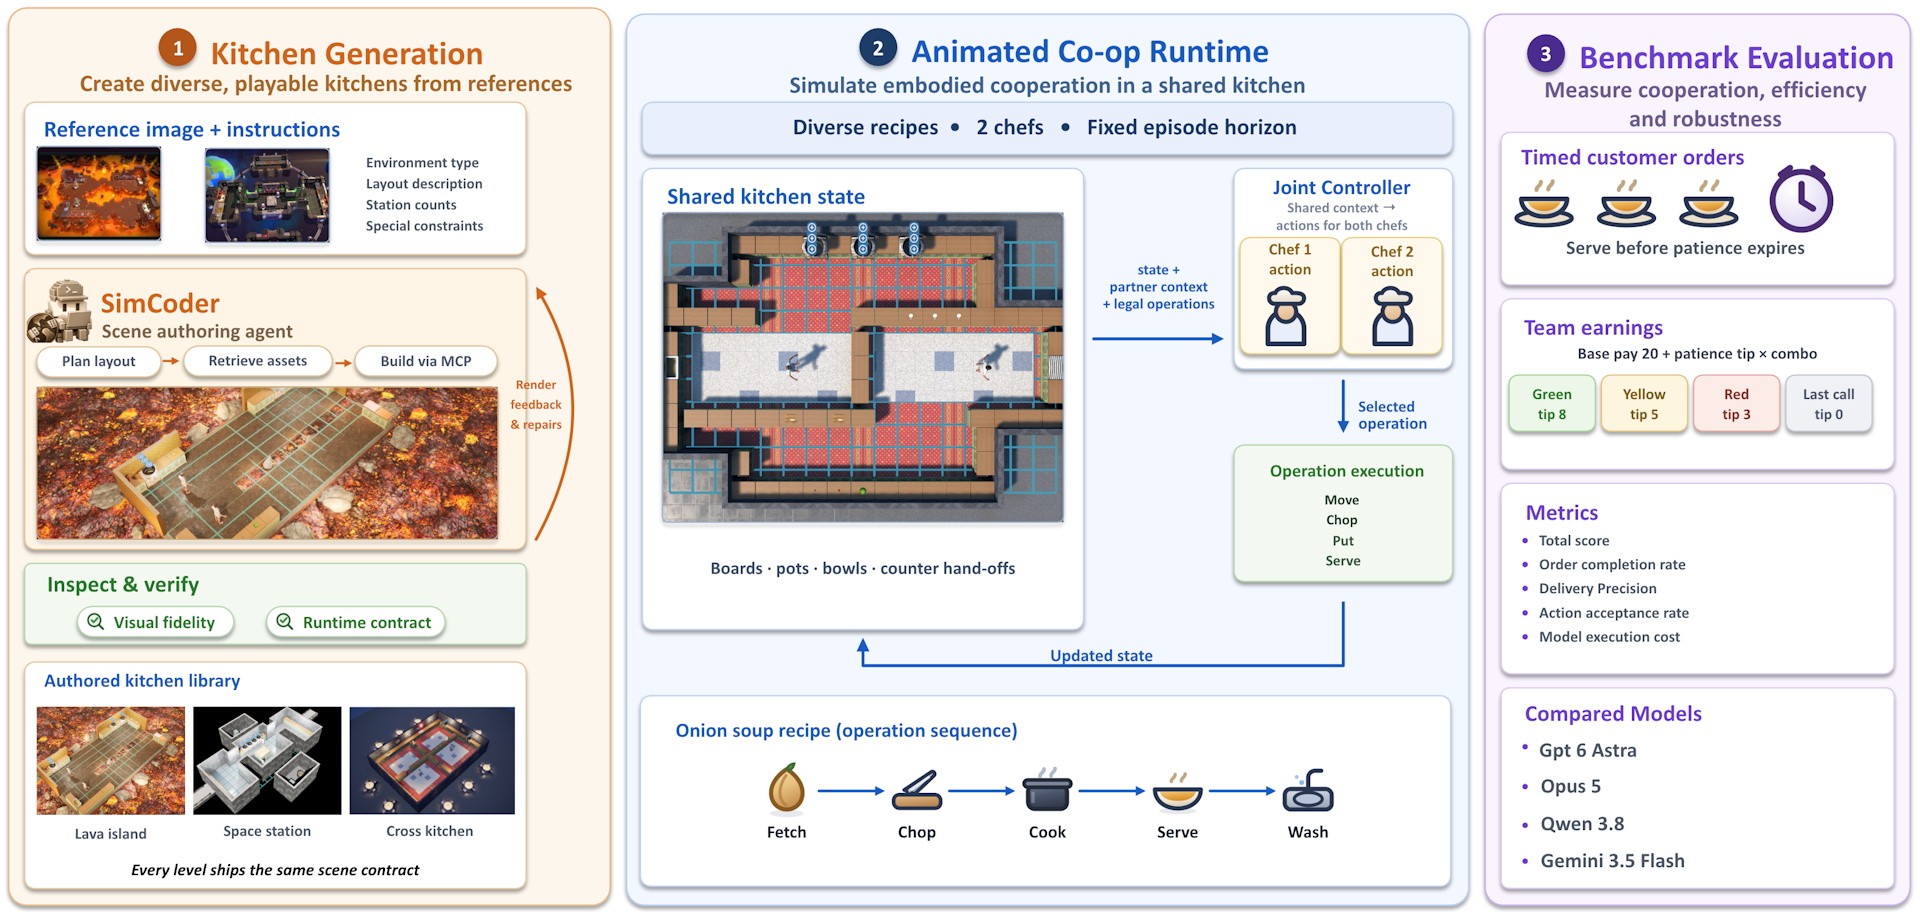
Forscher haben statt Menschen verschiedene KI-Modelle auf das Spiel losgelassen und getestet wie gut die Künstliche Intelligenz diese Aufgaben koordinierend bewältigen kann. Getestet wurden vier Vision-Language-Modelle, also KI-Systeme, die Bilder und Text verarbeiten können. Ein einziges Modell steuert dabei beide Spielfiguren gleichzeitig.
Ergebnisse - Selbst bestes Modell ist unterirdisch
Die Ergebnisse sind ernüchternd: Das stärkste Modell im Test, GPT-6-Astra, erledigte durchschnittlich 26,2 Prozent der Bestellungen. Die drei anderen Modelle kamen lediglich auf 8,8 bis 11,2 Prozent. Besonders problematisch waren Karten mit dynamischen Hindernissen und gemeinsam genutzten Geräten sowie Küchenbereiche, zwischen denen Zutaten übergeben werden mussten.
Auch ein zusätzliches Gedächtnis half nicht zuverlässig. Die Forschenden ergänzten ein gemeinsames Notizbuch, in dem die Agenten Beobachtungen festhalten konnten. Claude verbesserte seinen durchschnittlichen Punktestand in diesem Versuchsaufbau, während GPT und Gemini sogar schlechter abschnitten. Gleichzeitig stiegen die API-Kosten bei allen vier Modellen.
Relevanz - Aufgaben koordinieren ist schwierig
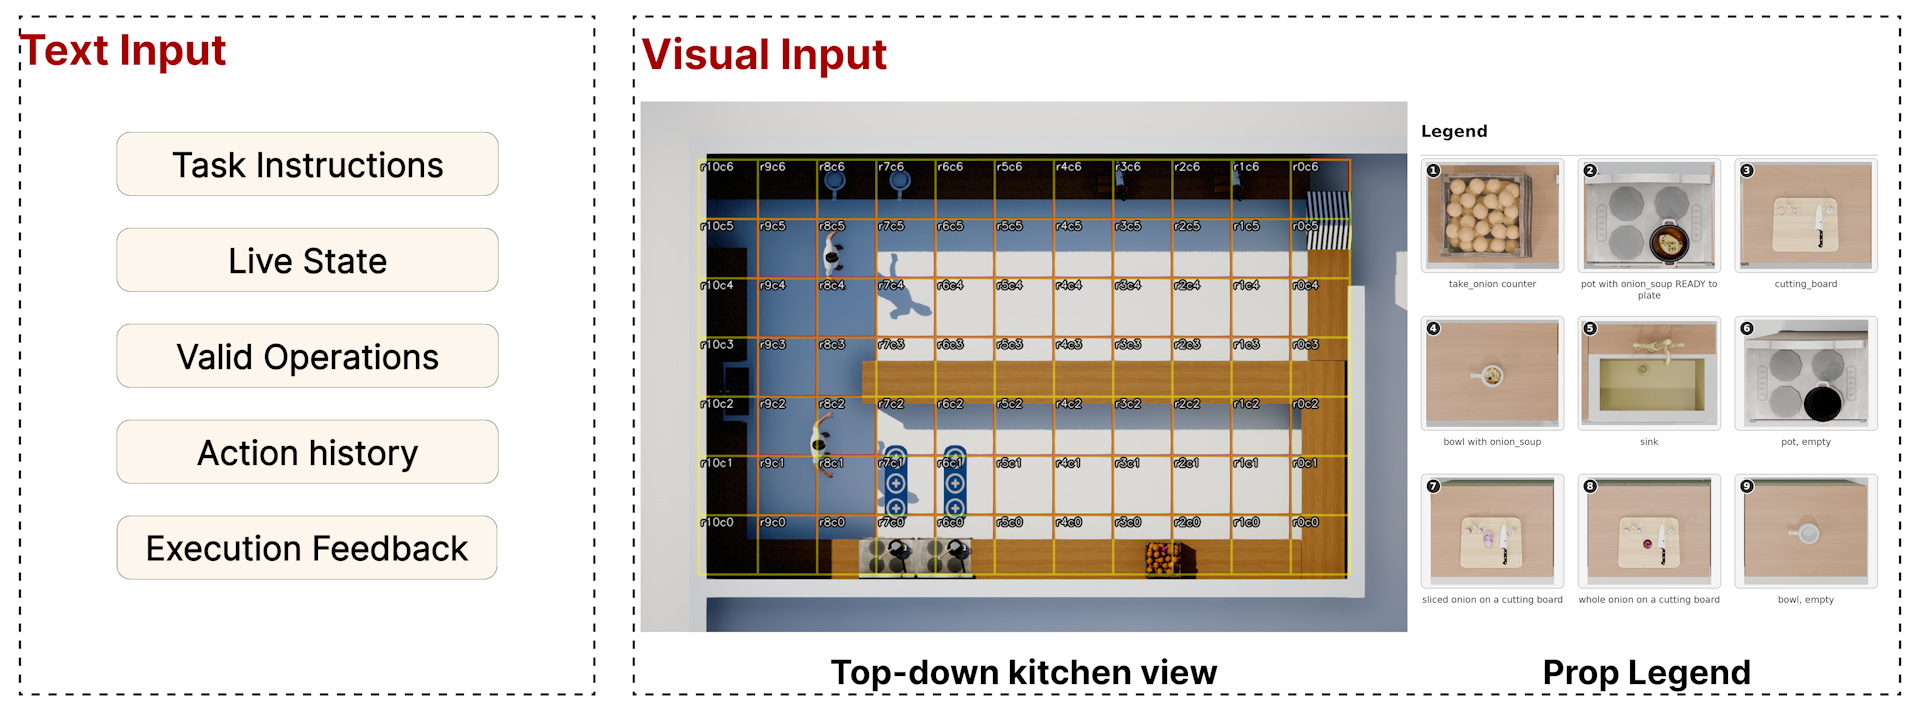
Die eng umrissene Aufgabe macht die Ergebnisse interessant, aber auch begrenzt. Trotz Hilfestellungen wie ein Raster zur Positionsbestimmung, eine Legende der Küchengeräte, strukturierte Statusinformationen und eine Liste zulässiger Aktionen bleibt die Koordination schwierig.
Für die Praxis ist das relevant, weil dieselben Probleme auch bei autonomen KI-Agenten außerhalb von Spielen auftreten können: Aufgaben aufteilen, Ressourcen verwalten, Zwischenziele verfolgen und auf veränderte Bedingungen reagieren.
Die Studie ist jedoch mit etwas Vorsicht zu genießen, es handelt sich um einen Preprint, sie hat also noch nicht zwingend das reguläre Begutachtungsverfahren einer Fachzeitschrift oder Konferenz durchlaufen. Im Link unten kann die komplette Studie nachgelesen werden.
Quelle(n)
 Als bevorzugte Quelle auf Google hinzufügen


